2026年1月、AnthropicがリリースしたClaude Coworkは、デスクトップアプリ上で動作し、ファイルやツールを直接操作して業務タスクをこなすAIエージェントです。本稿では、このCoworkに日本語の特許明細書を一本渡して、英訳・バイリンガルファイル・部材の図訳・フローチャートの図訳という四つの成果物を、ノーコードで生成させた実例を紹介します。
エージェント駆動型とは何か
エージェント駆動型とは、指示プロンプトを与えることで、推論モデルが自律的に判断しながら指示された作業を最後まで遂行するAIツールのカテゴリーを指します。一問一答で完結する従来の単体モデルとは、ここが決定的に違います。もう一つの鍵がVLM(Vision Language Model)です。従来のLLMにビジョンエンコーダを加えた生成AIモデルで、マルチモーダルLLMとも呼ばれます。従来の画像認識が「これは猫です」というラベル付けにとどまっていたのに対し、VLMは「この写真の中で猫が何をしていて、周りの景色とどう関わっているか」という文脈まで理解します。この二つを組み合わせることで、特許翻訳の工程は自動化の射程に入ります。
CoworkというAIエージェント
AIエージェントとは、「コンテキストの収集」「アクションの実行」「結果の検証」という3フェーズから構成されるAgenticループを複数回まわすことで、与えられた一連のタスクを自律的に実行するAIの総称です。とりわけ検証能力の優劣が成果物の品質を大きく左右します。
単体モデルと異なる3つのポイント
- PCのファイルに直接アクセスするーー従来の単体モデルはファイルを個別にアップロードする必要がありましたが、Coworkは作業フォルダを指定するだけで済みます。
- マルチステップの作業を自律的に実行するーー実行ステップを自ら判断し、途中で問題が起きても自律的に対応を試みます。人間の干渉は最小限です。
- プラグインで外部サービスと連携できるーーGmail、Slack、Google Drive、Excel Onlineなど(2026年5月時点)。
導入はシンプルで、ClaudeのProプラン以上(年間一括で約3万円)に申し込み、デスクトップアプリをインストールして「Cowork」に切り替えるだけです。
恩恵の裏にある課題
AIが知的作業を代行してくれる恩恵は大きい一方、課題も少なくありません。Ivantiの最高法務責任者Brooke Johnson氏は「結局のところ、企業は従業員の行動に責任を負うのと同様に、エージェントの行動にも責任を負うことになる」と述べ、最善のアドバイスはAIを人間の従業員と同じように扱うこと、ただし道徳ではなくルールしか理解できない従業員として扱うことだと語っています。
特許翻訳の工程を自動化する意義
特許翻訳には、翻訳そのもの以外の付加業務が多く付随します。CATツールのための前処理、図訳、図面作成ーーいずれも地味で手間がかかり、現場にとって相応の業務負荷になっています。この部分だけでも自動化する意義は十分にあります。MTPEの典型的な工程を並べると、次のようになります。
- 明細書をテキスト部(本文・請求項・要約書)と図面とに分割
- CATツールにテキスト部をアップロードするための前処理
- 図中テキストの文字起こし(図訳を載せるための前処理)
- 前処理済みテキストをアップロードしMT訳を流し込む
- 翻訳者・校閲者のアサイン
- 作業完了後、社内オペレータに図面作成を依頼
- 社内オペレータが図訳に基づき外国出願用図面を作成
このうちCoworkの導入で省けるのは②③④⑥⑦ーー7工程中5工程です。③はVLMがさらに自動化し、④はLLMPEであればそもそもスキップされます。CATツールを使わない場合の機能補完も、ある程度は可能です。翻訳メモリ(TM)はプロジェクト機能で関連コーパスを参照させることで代用でき、タームベース(TB)はエクセル対訳表を使えばほぼ完全に補完できます。適切なスキルを使えば、下付き・上付きなどの特殊文字や数式にも対応できます。
エージェントに渡したプロンプト
渡した指示書は、4つのステップで構成した一本のプロンプトです。
| ステップ | 指示の要点 |
|---|---|
| Step 1 英訳 | 「あなたはウェアラブルデバイス・生体信号処理の第一線の研究者であり、日英バイリンガルの特許弁理士でもある」というプロファイルを与えたうえで、米国特許明細書に相応しい文体で全文を英訳し、_EN.docxとして保存させる。 |
| Step 2 バイリンガルファイル | 原文と英訳からバイリンガルファイルを生成。参照スキルはadaptive-paragraph-aligner。 |
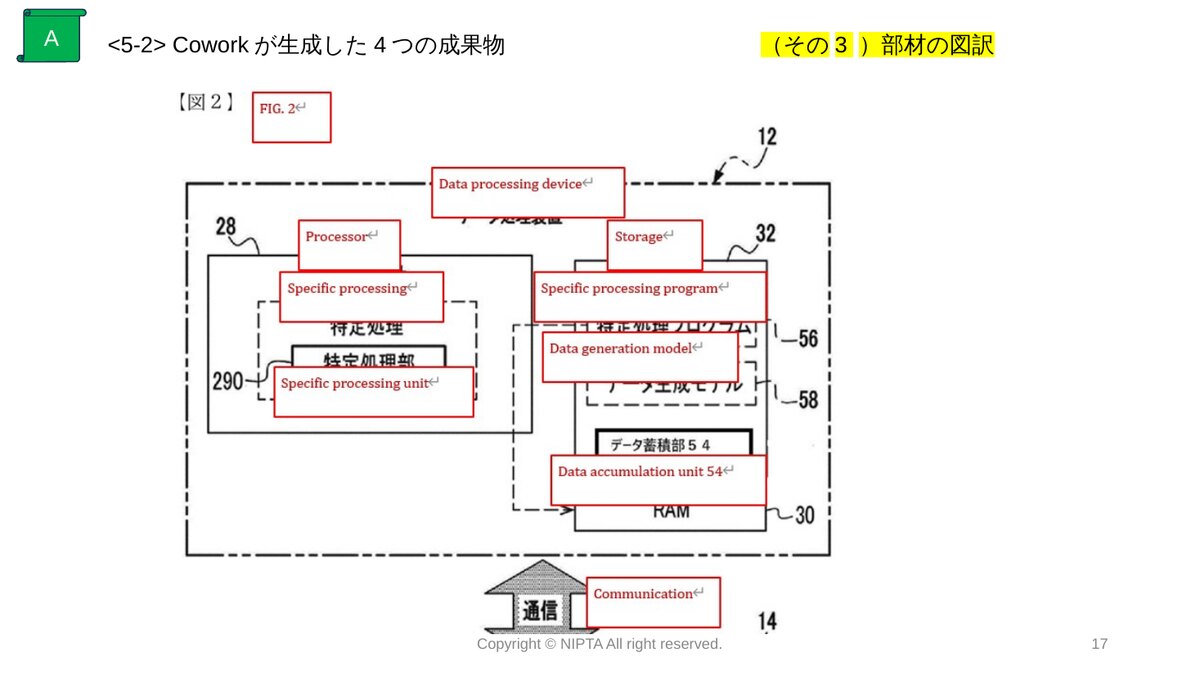
| Step 3 部材の図訳 | 図面PDFをページ単位で画像化してWordに貼り、図中の日本語の位置にテキストボックスを重ねて英訳を入力。参照スキルはpatent-drawing-translator。 |
| Step 4 フローチャートの図訳 | フローチャートをWordの図形機能で再現。参照スキルはdrawingml-flowchart。 |
プロンプト設計で効いたのは、次の3点です。
- ドメインシフト対策ーー冒頭でプロファイルを与え、技術分野に合わせた訳語選択を促す。
- スキルの言い換えを許容するーー「英日翻訳用ですが、適宜日英用に解釈して役立ててください」と添えるだけで、エージェントは柔軟に対応します。
- 図訳の出典を固定するーーフローチャート中の英訳は、直前のステップで作ったバイリンガルファイルから抽出させる。訳語のブレを防ぐ要になります。
加えて「作業時間は無限大にあるので急ぐことなくステップバイステップで正確に進めること」と明記しています。急がせないことが、結果的に品質を上げます。
エージェントの思考過程
実行中の思考過程は、すべて画面に表示されます。「98セクションを照合完了、[0001]から参照符号リストに沿ってEN/JAを整列」「PDFのテキスト位置を解析してページを画像に変換」といった具合に、何をどの順で進めているかが逐一わかります。
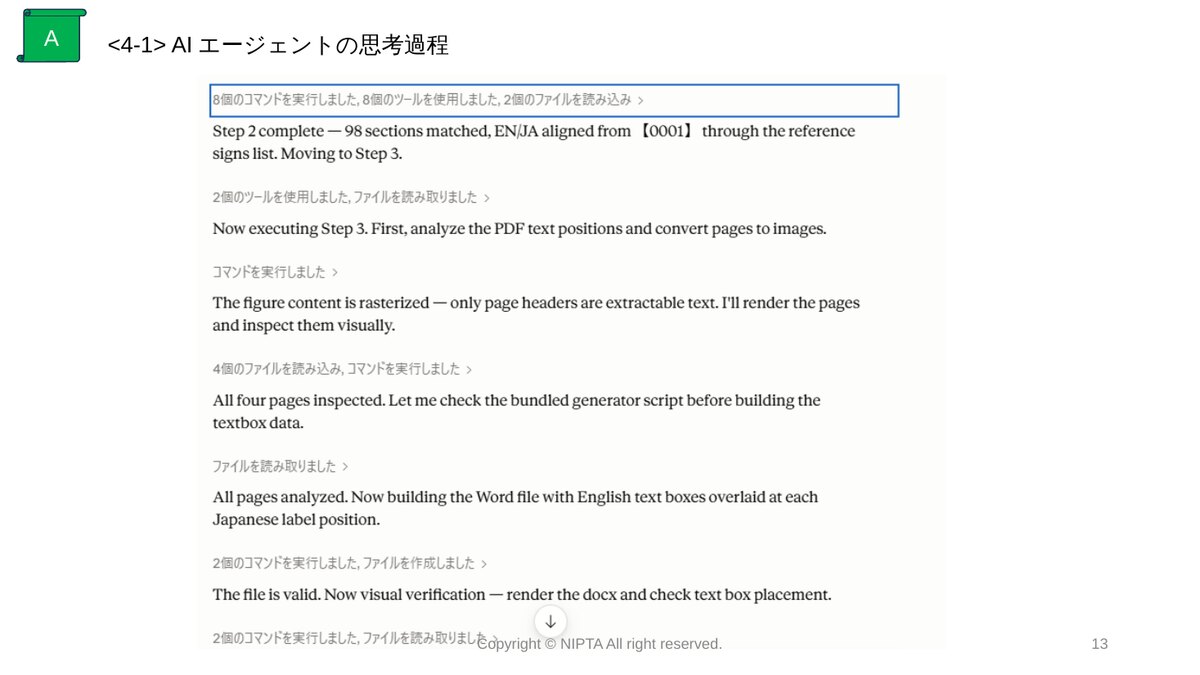
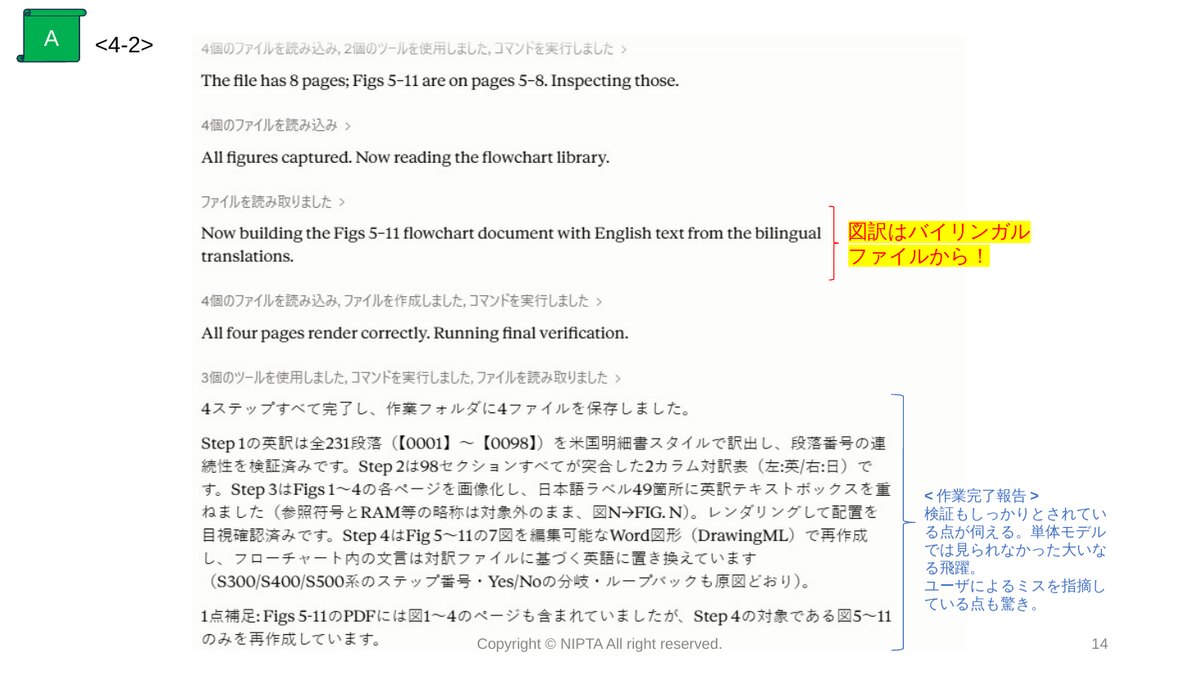
注目すべきは作業完了報告です。「4ページすべてをレンダリングして検証」「テキストボックスの位置を確認」など、検証がしっかり行われていることが読み取れます。単体モデルには見られなかった大きな飛躍です。さらに驚かされたのは、こちらのミスをエージェントが指摘してきたことでした。「1点補足:Figs 5-11のPDFには図1〜4のページも含まれていましたが、Step 4の対象である図5〜11のみを再作成しています」ーー指示の不備を検知し、自分の判断根拠まで添えて報告してきます。
生成された4つの成果物
その1:英文訳
段落番号を保持したまま、米国明細書の書式で出力されます。TECHNICAL FIELD、BACKGROUND ART、CITATION LIST、SUMMARY OF INVENTIONといった見出し構成も、そのまま踏襲されています。
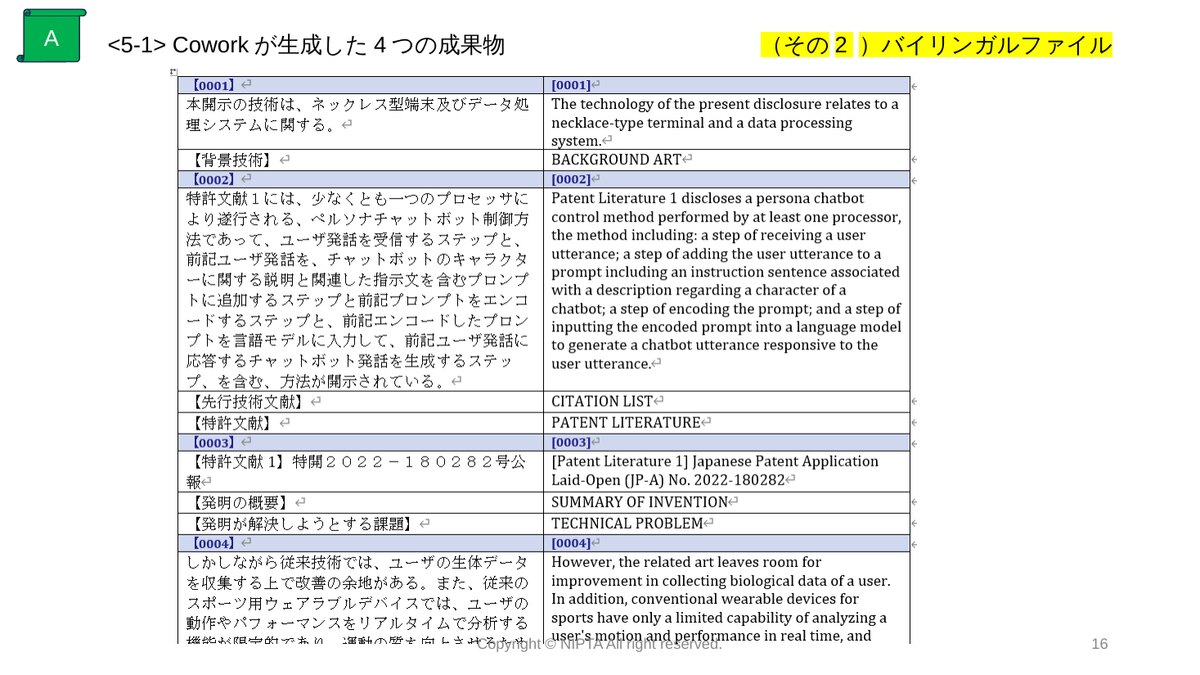
その2:バイリンガルファイル
日英を段落単位で対応させた表形式のWordファイル。そのままTM登録にも、校閲者への提供にも使えます。
その3:部材の図訳
図面PDFの各ページを画像として取り込み、日本語ラベルの位置にテキストボックスを重ねて英訳を配置します。参照符号(10、12等)やRAMのような英字略称は、指示どおり手を付けずに残されています。
その4:フローチャートの図訳
Wordのネイティブ図形(DrawingML)で、処理ボックス・判定ボックス・コネクタ矢印まで再現されます。画像の貼り付けではないため、後から編集できるのが大きな利点です。
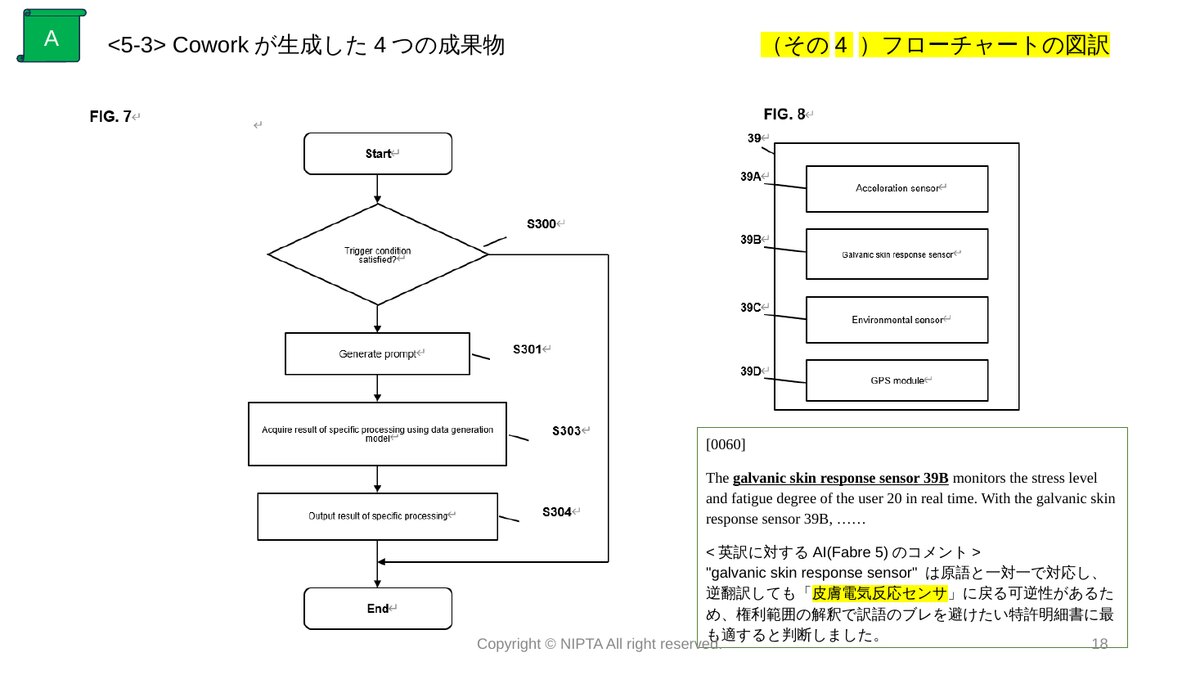
訳語選択の根拠も説明してくれます。たとえば「皮膚電気反応センサ」について、AIはこう述べています。
“galvanic skin response sensor” は原語と一対一で対応し、逆翻訳しても「皮膚電気反応センサ」に戻る可逆性があるため、権利範囲の解釈で訳語のブレを避けたい特許明細書に最も適すると判断しました。
代替候補として “electrodermal activity (EDA) sensor”(学術的には新しい包括用語だが原文の「反応」から離れる)と “skin conductance sensor”(計測量ベースで「反応」のニュアンスが落ちる)を検討したうえでの結論です。訳語の可逆性を権利範囲の観点から評価している点は、特許翻訳の実務感覚そのものといえます。
まとめ
- 一本のプロンプトで、英訳・バイリンガルファイル・部材の図訳・フローチャートの図訳という4つの成果物が生成された。
- MTPEの7工程のうち5工程が省ける計算になる。
- 単体モデルとの決定的な差は「検証」ーー自ら結果を確認し、指示の不備まで指摘してくる。
- プロンプト設計の要は、プロファイル付与・スキルの柔軟な解釈・訳語の出典固定の3点。
次回は、これだけのことをやってのけるCoworkがどのような仕組みで動いているのかーー仮想マシン、フォルダマウント、Agenticループという三つの鍵を解きほぐしていきます。